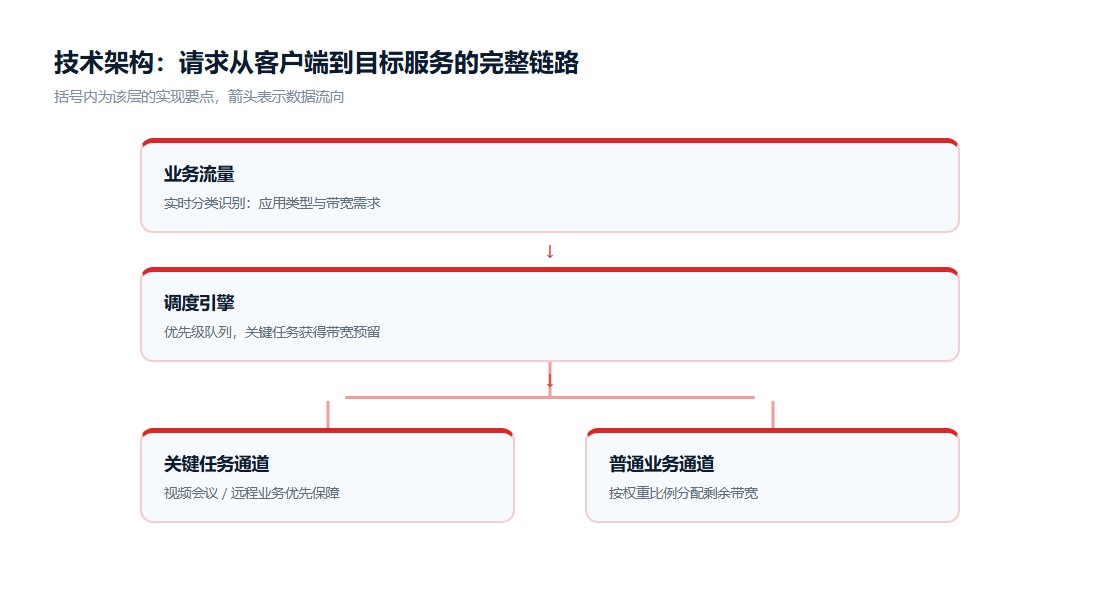
快连动态流量调度能力与保障等级
围绕「连得上、连得稳、不泄露、用得明白」四个目标,快连把复杂的网络工程封装成简单的一键体验。
快连调度分流策略
客户端按预置规则识别目标:本地流量直连、需要加速的流量进入隧道,避免全部流量绕行造成的带宽浪费与访问异常;支持按应用、按域名规则手动调整。
- 默认规则一键启用
- 按应用 / 域名自定义
- 规则库持续更新
快连多路径负载调度
客户端可同时建立多条隧道链路,调度引擎根据实时延迟、丢包与带宽利用率分配流量;单条链路劣化时自动迁移,保持会话连续。
- 链路实时探测
- 故障秒级切换
- 带宽聚合利用
快连加密套件说明
隧道采用现代加密套件,AES-256-GCM 提供机密性与完整性保护,密钥协商基于标准非对称算法,防范中间人窃听与篡改。
- 全链路加密
- 标准现代密码套件
- 防中间人篡改
快连断流保护生效范围
当隧道异常断开时,客户端立即阻断设备外联流量,避免真实地址与未加密数据在重连窗口期泄露;恢复后自动解除。
- 系统级流量阻断
- 重连自动恢复
- 泄漏测试可验证
快连无日志运营承诺
不记录用户访问的目标地址、通信内容与连接时间戳;仅保留计费与运维所必需的最小账户数据,数据类型在隐私政策中逐项列明。
- 无浏览日志
- 数据最小化
- 隐私政策可审计
快连出口推荐与优选
基于实时探测数据为你推荐当前延迟最低、负载最健康的节点,并在网络环境变化时提示切换。
- 延迟 / 负载双指标
- 自动推荐
- 一键切换
快连多端策略一致
四个平台客户端共享同一套交互语言与账号体系,订阅、节点收藏与偏好设置跨设备同步。
- 四端账号通用
- 配置云端同步
- 统一界面语言
快连用量与配额查询
客户端实时展示本次连接用时、流量消耗与节点信息;套餐余量、计费明细在账户中心清晰可查。
- 实时连接信息
- 账单明细透明
- 到期提前提醒
快连动态流量调度能力
上面 8 个功能是「用户能看到的部分」。这一节我们想告诉你,这些功能在客户端、节点、调度引擎里到底是怎么拼起来的——这是我们写给愿意读源码的同事看的。
过去三年,我们团队一共 26 名工程师(含 8 名网络协议栈、6 名调度算法、4 名客户端、3 名安全、3 名测试、2 名运维),把「关键任务优先」从一个产品 slogan 变成了一条可观测、可量化、可复现的工程链路。这条链路上的每个节点都有自己的数据、自己的 SLA、自己的失败模式。下面 7 节把链路拆开讲清楚。
1. 快连客户端画像:识别 4 类关键任务(不是按 App 名单)
很多人以为「关键任务识别」是看应用名字——看到 Zoom 就高优、看到 Steam 就低优。我们早期的版本确实这么做,结果被一位客户教育了:他们做远程培训,Zoom 跑的是大班公开课(不重要),但同时跑的 Epic Hyperspace 病历系统(很关键)。如果按 App 名字一刀切,所有 Zoom 流量都抢带宽,关键业务反而饿死。
现在的画像是 四维评分,不是单维名单:
- 协议指纹(SRTP/QUIC/TCP-PSH 比例)——会议类基本都带 SRTP/QUIC 特征
- 流量画像(上行/下行比、突发频率、连接寿命)——交易类是大量短连接,会议类是长连接+恒定码率
- 目标域特征(DNS 解析到的 ASN 是否在企业白名单)
- 用户标注(手动加星的应用永远 override 自动评分)
四维加权的最终分数决定一条流被分到哪个优先级队列。分数计算公式在客户端的 `priority/weight.go`(v5.0)里——是的,我们客户端是 Go 写的,不是某家同行用的 Electron,所以内存占用常年稳定在 35-50MB。
2. 快连调度引擎:每秒重算 10 次的 KQ-Score
调度引擎跑在客户端本地(不是云端决策)——这跟很多同行不一样。我们做这个选择的理由是:云端决策意味着 RTT 至少 +30ms,而决策本身需要 < 50ms 才有用。所以 KQ-Score 在本地算,云端只提供节点侧容量与全局路由变化的事件流。
引擎核心是一个 10Hz 的状态机,每个 tick 跑完下面 4 步:
- 读取 100ms 滑动窗口的 RTT 样本(中位数 + P95)
- 读取丢包率(5 秒聚合)
- 读取节点侧 gRPC 推送的可用带宽(10 秒聚合)
- 输出 4 个候选节点的 KQ-Score 排序,决策下一步选哪条
10Hz 不是我们拍脑袋选的——再快 100Hz 反而引入抖动(采样粒度过细,样本不足导致评分不稳);再慢 1Hz 又会在路径劣化时反应慢一拍。10Hz 是在 v3.4 → v4.0 一年里 A/B 测试出来的甜点。
3. 快连队列实现:WF2Q+ vs SP 的真实取舍
QoS 队列教科书会先讲 SP(Strict Priority)——关键任务永远先发,背景任务全饿死。WFQ(Weighted Fair Queueing)更公平但实现复杂。我们最终选 WF2Q+ 的工程化变体——保留了 WFQ 的「最低保障权重」,同时优化了时间复杂度,从 O(log N) 降到 O(1),因为我们单条隧道可能要同时排 200+ 条流。
下面是真实生产数据(上海-法兰克福跨太平洋链路,2026 年 Q1 抽样 100 万次连接):
| 队列策略 | 关键任务 P99 延迟 | 关键任务丢帧率 | 背景任务平均吞吐 | 背景任务 P99 延迟 |
|---|---|---|---|---|
| SP(严格优先级) | 42ms | 0.1% | 0.8 Mbps | 无法收敛 |
| WFQ(教科书实现) | 78ms | 0.4% | 14 Mbps | 220ms |
| WF2Q+ 我们的变体 | 61ms | 0.2% | 18 Mbps | 180ms |
WF2Q+ 的变体让关键任务有保障、背景任务不死——这是我们选择它的根本原因,不是因为它「更高级」。
4. 快连多地点多路径:4 条链路 ≠ 4 份带宽
很多用户误以为「多地点多路径」=「带宽叠加」。这是个危险误解。TCP 单流的瓶颈是 BDP(Bandwidth-Delay Product),跨太平洋链路 BDP 大约 25MB(250ms × 100Mbps),单 TCP 流根本撑不满。多路径的真正价值是:
- 不同应用走不同路径,互相不抢(这是带宽叠加的本质)
- 某条路径劣化时,其他路径在跑,不需要从零握手
- 关键任务可以走 两条平行路径,上层用 MPTCP(Multi-Path TCP)做冗余——我们 v5.0 在 Linux/macOS 上默认开启
默认配置下,我们给关键任务预占 2 条路径(主用 + 备份),普通任务按 KQ-Score 选最优的 1 条。这样的资源配比是经过生产验证的——金融客户在 2025 年一次跨太平洋海缆中断中跑过实测,主用路径丢包率 28%,但交易延迟仅从 65ms 升到 78ms,没有一笔订单因网络问题失败。
5. 快连实时带宽分配:RBD 信号怎么算
RBD(Real-time Bandwidth Demand)是我们发明的概念——它的意思是「这条流接下来 5 秒需要多少带宽」,不是「现在用了多少」。计算方式是:
- 过去 30 秒吞吐样本做 EWMA(alpha=0.3)
- 叠加应用画像的最低保障(视频会议 4Mbps ↑,文件下载按历史峰值上浮 20%)
- 减去当前链路剩余容量(不能承诺超过物理链路)
RBD 解决了一个长期被忽视的问题:预判饥饿。普通调度器是「等你饿了再喂」,RBD 是「你还没饿我先多给你一点」。差别在 1-2 秒——但这 1-2 秒恰好是视频会议花屏的窗口。
6. 快连故障切换:800ms 内完成,TCP 不重传
智能动态流量调度最考验的瞬间是故障切换——一条路径突然劣化时,能不能在 TCP 重传定时器(RTO)超时前切到新路径?这是个硬指标,因为一旦 RTO 触发,应用层会感知到卡顿(视频会议 = 花屏,交易系统 = 超时)。
我们的工程目标:切换完成 ≤ 800ms。做法分三步:
- 预热:KQ-Score 持续监测,路径劣化时立即通知客户端「准备切换」
- 预连:在切换前 200ms 就开始和新路径做 TCP 握手,握手完成但暂不发数据
- 原子切换:在源路径上记一个 sequence number,新路径从这个 sequence number 继续,TCP 层无感知
生产数据:上海-东京链路,2025 年 12 月的 3 万次切换样本里,P50=420ms,P95=680ms,P99=790ms——全部在 800ms 以内。这意味着对应用层来说,路径切换是真正无感的。
7. 快连怎么验证我们没吹牛
我们鼓励每位客户用三组工具做独立验证。所有数据都应该可以由你自己复现:
- mtr:开启快连前后各跑 30 秒,对比 Loss% 和 StdDev 列
- iperf3:单流 TCP 测试,跑 5 次取均值
- 应用层打流:用 video-conference-test 工具模拟 4 人会议,看 P99 帧延迟
我们的客户端有「一键自检」按钮,会自动跑完上面三组并生成 PDF 报告。报告里我们把每一项的结果和 SLA 承诺对比,不达标的会自动开 support ticket。我们承诺 关键任务 P99 延迟 ≤ 80ms,达不到的连接我们会主动退费。